معرفی ۸ محصول زیرساخت هوش مصنوعی انویدیا بر پایه معماری Blackwell

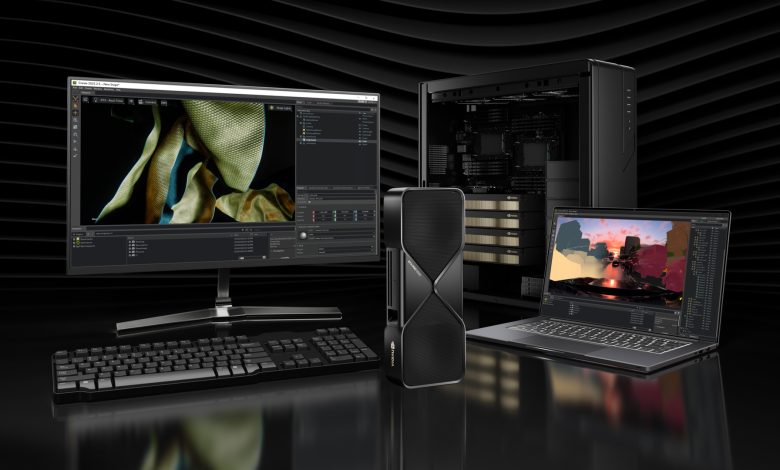
محصولات انویدیا Blackwell با معرفی نسل جدیدی از فناوریهای پردازشی، مرزهای هوش مصنوعی و محاسبات پیشرفته را جابجا کردهاند. این خانواده از سختافزارها، شامل سیستمهای مقیاسپذیر برای پاسخگویی به نیازهای پیچیده مدلهای تریلیون پارامتری و کاربردهای هوش مصنوعی در مقیاس جهانی طراحی شدهاند. با ترکیب پردازندههای Grace CPU و Blackwell GPU، این محصولات عملکردی بیسابقه در استنتاج بلادرنگ، آموزش مدلهای بزرگ، و پردازش دادههای سنگین ارائه میدهند.
معماری منحصر به فرد NVLink-C2C و فناوری خنککاری مایع، هسته اصلی قدرت این سیستمها هستند. برای مثال، GB200 NVL72 با اتصال ۷۲ جیپییو در یک رک، سرعت پردازش مدلهای زبانی را تا ۳۰ برابر افزایش میدهد. از سوی دیگر، DGX SuperPOD به عنوان یک پلتفرم جامع، امکان استقرار سریع هوش مصنوعی در مقیاس سازمانی را فراهم میکند. این مقاله به بررسی جامع محصولات انویدیا Blackwell میپردازد و کاربردهای آن را در صنایع مختلف تحلیل میکند.
انویدیا با معرفی GB300 NVL72 یکی از قدرتمندترین محصولات انویدیا Blackwell را به جهان معرفی کرد. این سیستم رکمقیاس با طراحی خنککنندگی مایع، ۷۲ پردازنده گرافیکی NVIDIA Blackwell Ultra و ۳۶ پردازنده Grace مبتنی بر معماری Arm را در یک سکوی واحد ترکیب میکند. هدف اصلی این سیستم، پشتیبانی از عملیات استنتاج پیچیده و مقیاسپذیر است.
GB300 NVL72 تا ۶۵ برابر قدرت پردازشی بیشتری نسبت به معماری Hopper برای استنتاج مدلهای reasoning ارائه میدهد. این پیشرفت بینظیر به لطف ترکیب سختافزار فوق پیشرفته و زیرساخت شبکهای پرسرعت بهدست آمده است. انویدیا برای این منظور از فناوریهای شبکه مانند Quantum-X800 InfiniBand و Spectrum-X Ethernet در کنار ConnectX-۸ SuperNICs استفاده کرده است.
توسعهدهندگان میتوانند با استفاده از این سیستم، مدلهای زبان طبیعی (LLM) را با تریلیونها پارامتر در زمان واقعی اجرا کنند. همچنین این سیستم از NVLink نسل پنجم برای اتصال GPUها بهره میبرد که ارتباط سریع و پایدار بین ۷۲ GPU را فراهم میکند و آنها را مانند یک GPU غولآسا بهصورت یکپارچه عمل میدهد.
حافظه کلی این پلتفرم بیش از ۴۰ ترابایت است و پهنای باندی در سطح سرورهای فوقسریع ارائه میدهد. GB300 NVL72 یکی از اصلیترین محصولات انویدیا Blackwell برای پیادهسازی کارخانههای هوش مصنوعی مدرن محسوب میشود. این سیستم برای شرکتهایی طراحی شده که به توان پردازشی بالا و اجرای real-time نیاز دارند.
2. NVIDIA DGX SuperPOD: قلب تپنده دیتاسنترهای مدرن در محصولات انویدیا Blackwell
انویدیا DGX SuperPOD را بهعنوان یکی از جامعترین راهکارهای دیتاسنترها در مجموعه محصولات Blackwell توسعه داده است. این سیستم تنها یک مجموعه سختافزار نیست، بلکه یک سکوی کامل برای استقرار سریع، مدیریت و گسترش هوش مصنوعی در مقیاس بزرگ به شمار میرود. انویدیا در این راهکار، GPU، CPU، ذخیرهسازی، شبکه و نرمافزارهای مخصوص AI را به صورت یکپارچه ارائه میدهد.
ماژولهای DGX GB200 یا GB300 ساخت انویدیا، اجزای اصلی DGX SuperPOD را تشکیل میدهند. این ماژولها بهکمک فناوری شبکهای پیشرفته Quantum InfiniBand با یکدیگر ارتباط برقرار میکنند. این شبکهها دادهها را با کمترین تأخیر و بیشترین سرعت منتقل میکنند. معماری این پلتفرم به توسعهدهندگان اجازه میدهد مدلهای زبانی بزرگ با تریلیونها پارامتر را بهصورت همزمان آموزش دهند یا استنتاج کنند.
سیستمعامل DGX OS در کنار پشته نرمافزاری NVIDIA AI Enterprise، ابزارهایی مانند NGC، CUDA-X و دیگر ابزارهای تخصصی را یکپارچه میکند. این ترکیب به سازمانها کمک میکند تا در سریعترین زمان به بهرهبرداری برسند. تیمهای فناوری نیز میتوانند بدون نیاز به تجمیع سختافزارهای متفرقه، با استفاده از تنها DGX SuperPOD، مراکز دیتاسنترها راهاندازی کنند.
شرکتهایی نظیر Meta، OpenAI و AWS از DGX SuperPOD بهعنوان یکی از محصولات انویدیا Blackwell برای آموزش مدلهای نسل آینده استفاده میکنند. این سیستم، مقیاسپذیری بینظیر، پایداری بالا و قدرت پردازشی فراوان را در اختیار کاربران قرار میدهد.
3. NVIDIA RTX PRO In the Data center: شتابدهنده گرافیکی
انویدیا کارت RTX PRO ۶۰۰۰ Blackwell Server Edition را بهعنوان یک شتابدهنده حرفهای و قدرتمند برای دیتاسنترها طراحی کرده است. این محصول نقش کلیدی در مجموعه محصولات Blackwell ایفا میکند و انویدیا آن را بهطور خاص برای ترکیب بارهای کاری گرافیکی و هوش مصنوعی در زیرساختهای پیشرفته توسعه داده است.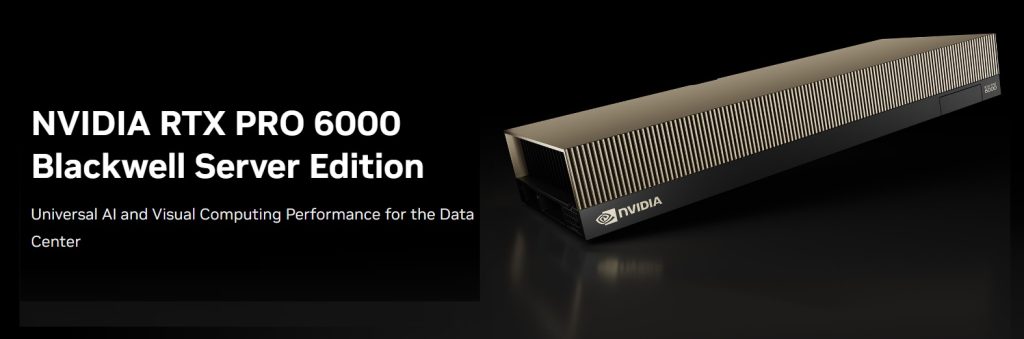
انویدیا این GPU را به ۹۶ گیگابایت حافظه بسیار سریع GDDR7 مجهز کرده است. این حافظه امکان اجرای همزمان مدلهای سنگین هوش مصنوعی و وظایف گرافیکی پیچیده مانند رندرینگ و شبیهسازی را فراهم میکند. RTX PRO ۶۰۰۰ از فناوریهایی مانند Tensor Core نسل جدید، فرمتهای FP4 و FP8، و تقسیمبندی MIG پشتیبانی میکند. این قابلیتها به تیمهای فنی اجازه میدهند چند کاربر بهطور موازی از یک GPU استفاده کنند.
کارت RTX PRO ۶۰۰۰ Blackwell Server Edition در استنتاج مدلهای زبانی عملکرد درخشانی دارد. همچنین در ژنومیکس، رندر سهبعدی و پردازش ویدیوی مبتنی بر هوش مصنوعی نیز توان پردازشی بالایی ارائه میدهد. در مقایسه با RTX A6000، این کارت تا ۵ برابر سریعتر در استنتاج، هفت برابر قویتر در پردازش ژنوم، و ۲ برابر بهتر در وظایف گرافیکی عمل میکند.
انویدیا پشتیبانی از DisplayPort ۲.۱، نصب در سرورهای passive و سازگاری با ابزارهای مدیریت دیتاسنتر را در این کارت فراهم کرده است. به همین دلیل، شرکتهایی که همزمان به قدرت هوش مصنوعی و گرافیک نیاز دارند، این کارت را انتخاب میکنند. در نتیجه، RTX PRO ۶۰۰۰ یکی از مهمترین محصولات انویدیا Blackwell در لایه دیتاسنتر بهشمار میرود.
4. NVIDIA RTX PRO Workstations: سکوی حرفهای طراحی و محاسبات
انویدیا پلتفرم RTX PRO را برای کاربران حرفهای در حوزههای طراحی، مهندسی، گرافیک و توسعه هوش مصنوعی طراحی و عرضه کرده است. این پلتفرم بهعنوان یکی از چندوجهیترین محصولات مجموعه Blackwell، نیاز کاربرانی را هدف قرار میدهد که به ترکیبی از قدرت گرافیکی بالا و توان محاسباتی پیشرفته هوش مصنوعی نیاز دارند.
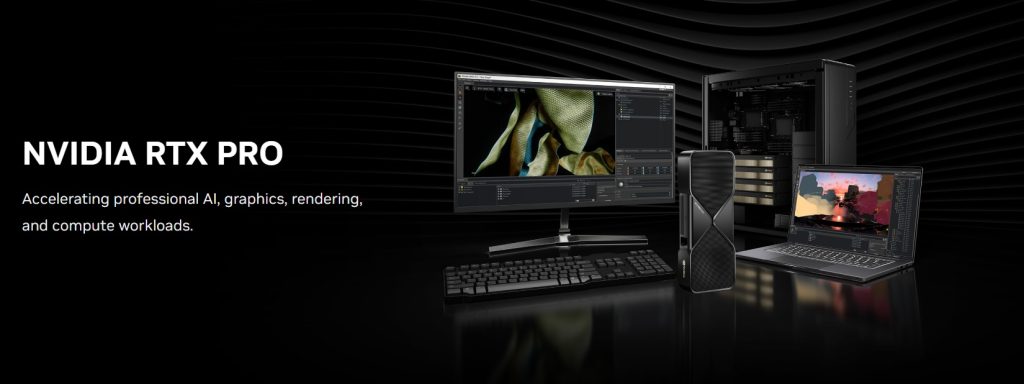
در قلب این پلتفرم، انویدیا از GPUهایی با معماری Blackwell استفاده کرده است. این GPUها به Tensor Core نسل جدید، RT Core نسل چهارم و قابلیتهای پیشرفتهای مانند ray tracing و shading عصبی مجهز هستند. کاربران میتوانند با تکیه بر این پلتفرم، پروژههایی مانند طراحی معماری، شبیهسازی صنعتی، رندرینگ سینمایی و آموزش یا fine-tuning مدلهای زبانی را اجرا کنند.
انویدیا در RTX PRO Platform پشتیبانی از فناوریهای نمایش پیشرفته مانند DisplayPort ۲.۱ را فراهم کرده است. کاربران با این ویژگی میتوانند از نمایشگرهای فوقوضوح و چندگانه در ایستگاههای کاری خود بهرهمند شوند. این پلتفرم با حافظه پرسرعت GDDR7 و فرمتهای جدید FP8 و FP4، اجرای مداوم و روان مدلهای هوش مصنوعی را ممکن میسازد. انویدیا سازگاری کامل این پلتفرم را با نرمافزارهای حرفهای تضمین کرده است. این پلتفرم بهخوبی با ابزارهایی مانند NVIDIA Omniverse، Blender، Autodesk و Unreal Engine هماهنگ میشود. به همین دلیل، شرکتهای فعال در حوزههایی مانند خودروسازی، انیمیشنسازی، واقعیت مجازی و تولید صنعتی از این پلتفرم بهطور گسترده استفاده میکنند.
در جمعبندی، انویدیا با پلتفرم RTX PRO یکی از اصلیترین ستونهای فناوری Blackwell را شکل میدهد. این پلتفرم با ترکیب قدرت محاسباتی هوش مصنوعی و گرافیک در یک چارچوب منسجم، سکویی قابلاتکا را در اختیار کاربران حرفهای قرار داده است.
5- NVIDIA DGX Station: ایستگاه دسکتاپی قدرتمند
انویدیا سیستم DGX Station را با هدف ارائه توان پردازشی عظیم در قالب دسکتاپی معرفی کرده است. این محصول منحصربهفرد جزئی از خانواده Blackwell بهشمار میرود. انویدیا DGX Station را بهگونهای طراحی کرده است که قدرت یک ابرکامپیوتر را با سادگی یک ایستگاه کاری ترکیب کند. این طراحی، استفاده از آن را در محیطهای غیردیتاسنتری ممکن میسازد. این سیستم، پاسخگوی نیاز تیمهای تحقیقاتی، استارتاپهای هوش مصنوعی و پژوهشگرانی است که قصد اجرای محلی مدلهای بزرگ را دارند.
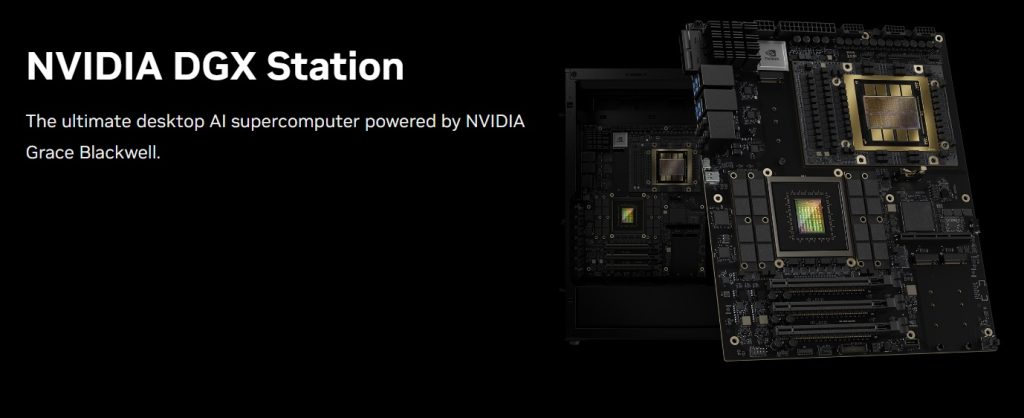 انویدیا در DGX Station از سوپرچیپ GB300 Grace Blackwell Ultra استفاده کرده است که شامل دو GPU قدرتمند Blackwell و یک پردازنده Grace با معماری Arm میشود. این ترکیب، بههمراه حافظه اشتراکی و همگن تا سقف ۷۸۴ گیگابایت، پردازش سریع و روان مدلهای زبان بزرگ را ممکن میسازد. انویدیا همچنین فناوری NVLink-C2C را برای برقراری ارتباط مستقیم و یکپارچه میان CPU و GPU در این سیستم بهکار میگیرد.
این سیستم با پشتیبانی از نرمافزارهای اختصاصی مانند CUDA-X، PyTorch، TensorFlow و RAPIDS، به توسعهدهندگان اجازه میدهد مدلهای پیچیده را آموزش دهند و بهآسانی روی آنها fine-tuning انجام دهند. طراحی دسکتاپی و سیستم خنککنندگی بیصدا نیز امکان استفاده از DGX Station را در دفاتر کاری و آزمایشگاهها فراهم میکند، بدون آنکه نیازی به زیرساخت دیتاسنتری باشد.
عملکرد DGX Station در مقایسه با ایستگاههای کاری سنتی چندین برابر بهتر است. این سیستم به تیمهای فنی کمک میکند تا مدلهای LLM پیشرفته را بهصورت محلی آموزش دهند و ارزیابی کنند. انویدیا با طراحی این محصول، بین قدرت دیتاسنتر و کاربری شخصی پلی مؤثر ایجاد کرده است. DGX Station به همین دلیل به یکی از کاربردیترین اعضای خانواده Blackwell تبدیل شده است.
6- NVIDIA DGX Spark: قدرتی جمعوجور برای مدلهای زبانی
انویدیا سیستم DGX Spark را برای کاربرانی طراحی کرده است که بهدنبال قدرت پردازشی بالا در قالبی کوچک و قابلحمل هستند. این محصول بهعنوان یکی از کاربردیترین اعضای خانواده Blackwell شناخته میشود و انویدیا آن را با هدف استقرار محلی مدلهای زبانی بزرگ (LLM) توسعه داده است.
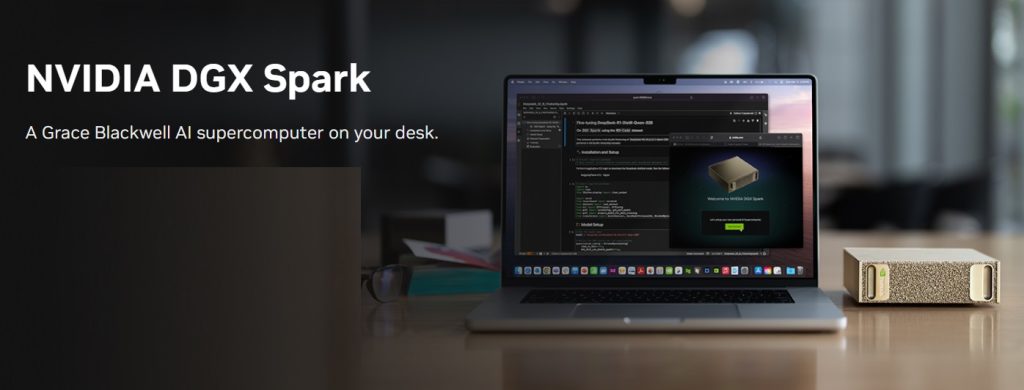 DGX Spark با بهرهگیری از چیپ قدرتمند GB10 Grace Blackwell، عملیات پیچیدهی هوش مصنوعی را با کارایی بالا و تأخیر بسیار پایین پردازش میکند.
انویدیا در این سیستم از ۱۲۸ گیگابایت حافظه پرسرعت HBM3e بهره گرفته است تا پشتیبانی از مدلهایی با حداکثر ۲۰۰ میلیارد پارامتر را ممکن سازد. این ظرفیت بالا به کاربران اجازه میدهد مدلهای هوش مصنوعی را در محیط محلی آموزش دهند، آزمایش کنند و بهروزرسانی نمایند. همچنین، انویدیا با ترکیب پردازنده Grace مبتنی بر معماری Arm و GPU قدرتمند Blackwell، امکان اجرای همزمان وظایف هوش مصنوعی و پردازش دادهها را فراهم کرده است.
انویدیا DGX Spark را با ابعاد کوچکتری نسبت به دیگر محصولات Blackwell طراحی کرده است. این طراحی جمعوجور باعث شده پژوهشگران، دانشگاهها و تیمهای کوچک توسعه بتوانند آن را در آزمایشگاه یا دفتر خود بهکار بگیرند، بدون نیاز به زیرساخت دیتاسنتری یا تجهیزات خنککننده خاص.
از نظر نرمافزاری نیز، انویدیا این سیستم را بهطور کامل با اکوسیستم NVIDIA AI هماهنگ کرده است. کاربران میتوانند از ابزارهایی مانند CUDA-X، NVIDIA Triton Inference Server و TensorRT بهرهمند شوند تا توسعه و استقرار مدلهای هوش مصنوعی را سریعتر و بهینهتر انجام دهند.
در مجموع، انویدیا با DGX Spark تجربهای از قدرت پردازشی سطح دیتاسنتر را در قالبی کوچک و قابلحمل ارائه میدهد. این سیستم جایگاه ویژهای در سبد محصولات Blackwell دارد و برای توسعه و اجرای مدلهای پیشرفته LLM در مقیاس کوچک، یک انتخاب ایدهآل بهشمار میرود.
7- NVIDIA HGX Platform: شتابدهنده هوش مصنوعی پیشرفته برای دیتاسنترها
انویدیا سکوی NVIDIA HGX B300 را بهعنوان یک راهکار انقلابی طراحی کرده است تا به نیازهای عصر جدید هوش مصنوعی و محاسبات پیشرفته پاسخ دهد. این سیستم با ترکیب پردازندههای قدرتمند Blackwell Ultra، حافظه گسترده، و فناوریهای ارتباطی پرسرعت، عملکرد بینظیری را در اجرای مدلهای پیچیده هوش مصنوعی، شبیهسازیهای علمی، و پردازش دیتاهای عظیم ارائه میدهد.
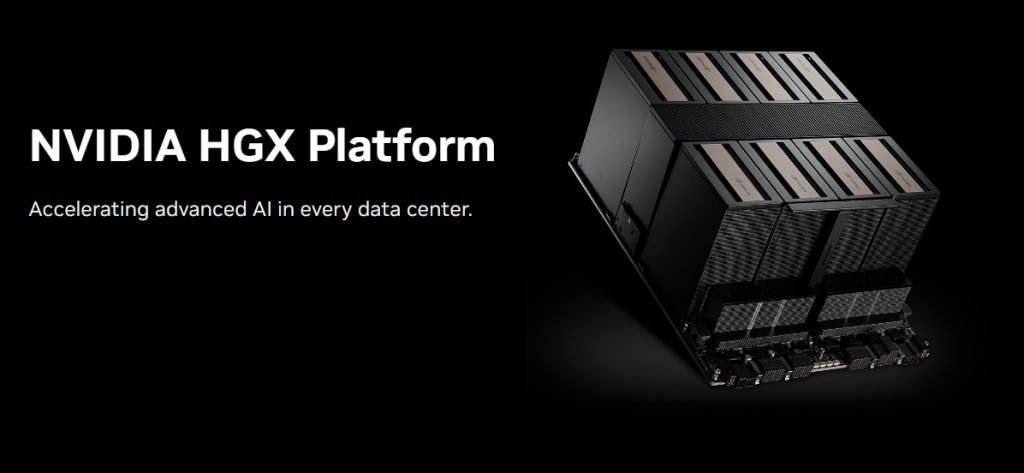
ویژگیهای کلیدی این پلتفرم عبارتاند از:
- افزایش ۱۱ برابری سرعت استنتاج هوش مصنوعی نسبت به نسل پیشین
- معماری بهینهشده مبتنی بر NVLink و اتصالات فوقسریع برای پردازش یکپارچه میان اجزای سیستم
- پشتیبانی از شبکههای ۸۰۰ گیگابیت بر ثانیه با استفاده از فناوریهای پیشرفته Quantum-X800 InfiniBand و یکپارچهسازی با DPU پیشرفته BlueField-۳ برای افزایش امنیت و مدیریت هوشمند منابع
انویدیا با توسعه HGX B300، یک پلتفرم end-to-end در اختیار دیتاسنترها قرار داده است که بهطور کامل نیازهای پردازشی سنگین هوش مصنوعی و محاسبات با کارایی بالا (HPC) را برطرف میکند. این پلتفرم نهتنها اجرای مدلهای Generative AI در مقیاس کلان را بهینه میکند، بلکه انویدیا با استفاده از آن، چالشهایی مانند تحلیل کلاندادهها و شبیهسازیهای علمی را نیز با کارایی چشمگیر حل میکند.
انویدیا با HGX B300 به دیتاسنترها کمک میکند تا بهراحتی وارد عصر جدید هوش مصنوعی تحلیلی و پردازش ابری شوند و این مراکز زیرساختهای خود را با بالاترین سطح مقیاسپذیری، امنیت و بهرهوری ارتقا میدهند.
8- NVIDIA GB200 NVL72: استنتاج بیوقفه برای مدلهای تریلیونی
انویدیا سیستم NVIDIA GB200 NVL72 را با معماری پیشرفته و سیستم خنککاری مایع طراحی کرده است تا قدرت پردازشی عظیمی را در یک رک یکپارچه ارائه دهد. در این سیستم، انویدیا ۳۶ پردازنده Grace و ۷۲ پردازنده گرافیکی Blackwell را بهگونهای به هم متصل کرده است که مانند یک ابرپردازنده واحد عمل میکنند و مدلهای زبانی تریلیون پارامتری (LLM) را با سرعتی تا ۳۰ برابر بیشتر نسبت به نسلهای قبلی پردازش میکنند.
 در قلب این معماری، سوپرچیپ Grace Blackwell قرار دارد. انویدیا با استفاده از فناوری NVLink-C2C، دو GPU Blackwell را به یک CPU Grace متصل کرده است تا نهایت بهرهوری در ارتباط بین پردازنده و شتابدهنده گرافیکی حاصل شود. این طراحی منحصربهفرد به کاربران اجازه میدهد استنتاج بلادرنگ را روی بزرگترین مدلهای هوش مصنوعی با بالاترین کارایی انجام دهند.
ویژگیهای کلیدی:
- پردازش مدلهای تریلیون پارامتری با سرعت بیسابقه
- معماری یکپارچه با ۷۲ GPU و خنککاری مایع فناوری اتصال NVLink-C2C برای ارتباط بهینه بین CPU و GPU
- افزایش ۳۰ برابری سرعت استنتاج مدلهای زبانی بزرگ نسبت به نسل پیشین
انویدیا با توسعه GB200 NVL72، تحولی اساسی در مقیاسپذیری و کارایی پردازش هوش مصنوعی ایجاد کرده است. این سیستم پاسخی قدرتمند به نیازهای دیتاسنترها پیشرفته و سازمانهایی ارائه میدهد که به پردازش مدلهای بزرگ در سطح جهانی نیاز دارند.