معرفی معماری پیشرفته NVIDIA GB۲۰۰ NVL۷۲؛ تحولی در آموزش و استنتاج بلادرنگ LLM های تریلیون پارامتری

مدل های تریلیون پارامتری نظیر NVIDIA GB200 NVL72 چرا جذاب هستند؟ میدانیم که امروز موارد استفاده زیادی دارند و علاقه به آنها به دلیل وعده افزایش ظرفیت در زمینههای زیر در حال رشد است:
- پردازش زبان طبیعی مانند ترجمه، پاسخ به سوالات، خلاصهنویسی و روانی گفتار.
- حفظ زمینه گفتگو در طولانیمدت و توانایی مکالمهای پایدار.
- کاربردهای چندوجهی که زبان، بینایی و گفتار را ترکیب میکنند.
- کاربردهای خلاقانه مانند تولید داستان، شعر و کدنویسی.
- کاربردهای علمی مانند پیشبینی ساختار پروتئین و کشف دارو.
- شخصیسازی با توانایی توسعه شخصیت پایدار و بهخاطر سپردن زمینه کاربر.
مزایا بسیار زیاد است، اما آموزش و استقرار مدلهای بزرگ میتواند از نظر محاسباتی پرهزینه و نیازمند منابع فراوان باشد. سیستمهای کارآمد از نظر محاسباتی، مقرونبهصرفه و بهینه از نظر انرژی که برای ارائه استنتاج در زمان واقعی طراحی شدهاند، برای استقرار گسترده حیاتی خواهند بود. NVIDIA GB200 NVL72 یکی از چنین سیستمهایی است که از عهده این کار برمیآید.
برای مثال، مدلهای Mixture of Experts (MoE) را در نظر بگیرید. این مدلها به توزیع بار محاسباتی بین متخصصان مختلف کمک میکنند و با استفاده از موازیسازی مدل و موازیسازی خط لوله، آموزش روی هزاران GPU را ممکن میسازند و سیستم را کارآمدتر میکنند.
اما یک سطح جدید از محاسبات موازی، حافظه پرسرعت و ارتباطات پرظرفیت میتواند خوشههای GPU را قادر سازد تا این چالش فنی را قابلحل کنند. معماری مقیاس-رک NVIDIA GB200 NVL72 به این هدف دست مییابد که در بخش بعدی مقاله به جزئیات آن میپردازیم.
طراحی در مقیاس رک برای یک ابررایانه هوش مصنوعی در مقیاس اگزاسکیل
قلب سیستم GB200 NVL72، سوپرچیپ NVIDIA GB200 Grace Blackwell است. این سوپرچیپ، دو پردازنده گرافیکی NVIDIA Blackwell Tensor Core GPU و پردازنده مرکزی NVIDIA Grace را با استفاده از رابط NVLink-Chip-to-Chip (C2C) به یکدیگر متصل میکند که پهنای باند دوطرفه ۹۰۰ گیگابایت بر ثانیه را فراهم میآورد.
با NVLink-C2C، برنامهها بهصورت یکپارچه به فضای حافظه مشترک دسترسی دارند. این امر برنامهنویسی را سادهتر کرده و نیازهای حافظه بزرگ مدلهای زبانی با تریلیونها پارامتر، مدلهای ترنسفورمر برای وظایف چندوجهی، مدلهای شبیهسازی در مقیاس گسترده و مدلهای مولد دادههای سهبعدی را پشتیبانی میکند.
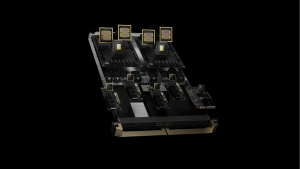
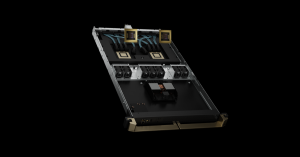
سینی محاسباتی GB200 بر اساس طراحی جدید NVIDIA MGX ساخته شده است. این سینی شامل دو پردازنده Grace CPU و چهار پردازنده گرافیکی Blackwell GPU است. GB200 مجهز به صفحات خنککننده و اتصالات خنکسازی مایع، پشتیبانی از PCIe نسل ۶ برای شبکههای پرسرعت و کانکتورهای NVLink برای کارتریج کابل NVLink است.
سینی محاسباتی GB200 با ارائه ۸۰ پتافلاپ قدرت پردازش هوش مصنوعی و ۱.۷ ترابایت حافظه پرسرعت، یک گام بلند در پردازش مقیاسپذیر محسوب میشود.
برای حل بزرگترین چالشها، به تعداد کافی از پردازندههای گرافیکی انقلابی Blackwell نیاز است که به صورت موازی و کارآمد عمل کنند. این پردازندهها باید با پهنای باند بالا و تأخیر کم با یکدیگر ارتباط برقرار کرده و به طور مداوم مشغول پردازش باشند.
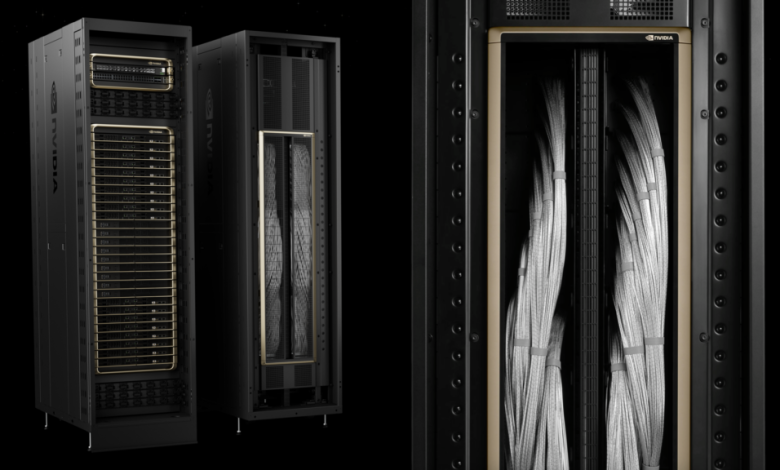
سیستم GB200 NVL72 در مقیاس رک، کارایی موازیسازی مدل را برای ۱۸ نود محاسباتی از طریق سوئیچ سیستم NVIDIA NVLink فراهم میکند. این سیستم شامل ۹ سینی سوئیچ NVLink و کارتریجهای کابل است که پردازندههای گرافیکی و سوئیچها را به هم متصل میکنند.
این معماری پیشرفته، امکان اجرای مدلهای عظیم با حداکثر بهرهوری را فراهم میسازد و چالشهای پردازشی در مقیاس ابررایانههای هوش مصنوعی را حل میکند.
NVIDIA GB200 NVL36 و NVL72
سری GB200 از دامنههای NVLink با پشتیبانی از ۳۶ و ۷۲ پردازنده گرافیکی بهره میبرد. هر رک میزبان ۱۸ نود محاسباتی مبتنی بر طراحی مرجع MGX و سوئیچ سیستم NVLink است. این سیستم در دو پیکربندی عرضه میشود:
-
GB200 NVL36: شامل ۳۶ پردازنده گرافیکی در یک رک با ۹ نود محاسباتی دوتایی GB200
-
GB200 NVL72: شامل ۷۲ پردازنده گرافیکی در یک رک با ۱۸ نود محاسباتی دوتایی GB200 (یا ۷۲ پردازنده در دو رک با ۱۸ نود تکی GB200)
سیستم GB200 NVL72 با استفاده از کارتریج کابل مسی، اتصال فشرده و بهینهای بین پردازندههای گرافیکی برقرار میکند که عملیات را سادهتر میسازد. همچنین با بهرهگیری از طراحی سیستم خنککنندگی مایع، ۲۵ برابر کاهش هزینه و مصرف انرژی را محقق میسازد.
نسل پنجم NVLink و سیستم سوئیچ NVLink
سری NVIDIA GB200 NVL72 از فناوری پیشرفته نسل پنجم NVLink بهره میبرد که امکان اتصال تا ۵۷۶ پردازنده گرافیکی را در یک دامنه NVLink واحد فراهم میکند. این سیستم با پهنای باند کلی بیش از ۱ پتابایت بر ثانیه و ۲۴۰ ترابایت حافظه پرسرعت، تحولی در پردازش موازی ایجاد کرده است.
هر سینی سوئیچ NVLink مجهز به ۱۴۴ پورت NVLink با سرعت ۱۰۰ گیگابیت بر ثانیه است. با استفاده از ۹ سوئیچ، هر ۱۸ پورت NVLink روی هر یک از ۷۲ پردازنده گرافیکی Blackwell به طور کامل به یکدیگر متصل میشوند.
پهنای باند دوطرفه ۱.۸ ترابایت بر ثانیه برای هر پردازنده گرافیکی، بیش از ۱۴ برابر پهنای باند PCIe Gen5 است. این ویژگی، ارتباط پرسرعت و یکپارچهای را برای پیچیدهترین مدلهای بزرگ امروزی ممکن میسازد و محدودیتهای ارتباطی در پردازشهای سنگین را از بین میبرد.
NVLink در طول نسلها
نوآوری پیشروی NVIDIA در زمینه SerDes پرسرعت و کم مصرف، پیشرفت در ارتباط GPU به GPU را ممکن ساخته است، از زمان معرفی NVLink برای تسریع ارتباطات چند-GPU با سرعت بالا. پهنای باند NVLink در ارتباط GPU به GPU معادل ۱.۸ ترابایت بر ثانیه است که ۱۴ برابر پهنای باند PCIe میباشد. نسل پنجم NVLink با ۱۶۰ گیگابایت بر ثانیه، ۱۲ برابر سریعتر از نسل اول در سال ۲۰۱۴ است. ارتباطات GPU به GPU با NVLink نقش کلیدی در مقیاس پذیری عملکرد چند-GPU در هوش مصنوعی و محاسبات عملکرد بالا(HPC) داشته است.
پیشرفتهای پهنای باند GPU همراه با گسترش نمایی اندازه دامنه NVLink، پهنای باند کلی یک دامنه NVLink را از سال ۲۰۱۴ تاکنون ۹۰۰ برابر افزایش داده و به ۱ پتابایت بر ثانیه برای یک دامنه NVLink با ۵۷۶ GPU Blackwell رسانده است.
موارد استفاده و نتایج عملکردی
قابلیتهای محاسباتی و ارتباطی GB200 NVL72 بیسابقه بوده و چالشهای بزرگ در حوزه هوش مصنوعی و محاسبات عملکرد بالا(HPC) را در دسترس قرار میدهد.
آموزش هوش مصنوعی
GB200 مجهز به موتور ترنسفورمر نسل دوم با دقت FP8 است که عملکرد آموزش را تا ۴ برابر در مقایسه با تعداد مشابه از پردازندههای NVIDIA H100 بهبود میبخشد. این پیشرفت در مدلهای زبانی بزرگ مانند GPT-MoE-۱.8T با استفاده از ۳۲,۰۰۰ واحد GB200 NVL72 بهوضوح قابل مشاهده است.
استنتاج هوش مصنوعی
GB200 با بهرهگیری از موتور ترنسفورمر نسل دوم، قابلیتهای پیشرفتهای برای تسریع بارهای کاری استنتاج مدلهای زبانی بزرگ (LLM) ارائه میدهد. این سیستم تا ۳۰ برابر بهبود عملکرد در کاربردهای پرمصرف مانند مدل GPT-MoE با ۱.۸ تریلیون پارامتر در مقایسه با نسل قبلی (H100) دارد. این پیشرفتها با معرفی Tensor Coreهای نسل جدید و پشتیبانی از دقت FP4 به همراه مزایای NVLink نسل پنجم ممکن شدهاند.
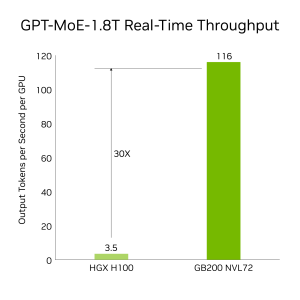
در نمودار فوق، نتایج بر اساس تأخیر توکن به توکن = ۵۰ میلیثانیه؛ تأخیر اولین توکن در زمان واقعی = ۵۰۰۰ میلیثانیه؛ طول دنباله ورودی = ۳۲۷۶۸؛ طول دنباله خروجی = ۱۰۲۴ خروجی، مقایسه عملکرد هر GPU در 9x هشتراهی HGX H100 خنکشونده با هوا: شبکه ۴۰۰ گیگابیتی IB در مقابل ۱۸ ابرچیپ GB200 خنکشونده با مایع: NVL72. عملکرد پیشبینیشده ممکن است تغییر کند.
پردازش داده
تحلیل کلاندادهها به سازمانها کمک میکند تا بینشهای جدیدی کسب کنند و تصمیمات آگاهانهتری بگیرند. سازمانها بهصورت مداوم دادهها را در مقیاس بزرگ تولید میکنند و برای کاهش گلوگاهها و صرفهجویی در هزینههای ذخیرهسازی، از تکنیکهای مختلف فشردهسازی استفاده میکنند. معماری بلکول برای پردازش کارآمد این مجموعه دادهها روی GPUها، یک موتور سختافزاری decompression معرفی کرده است که میتواند دادههای فشردهشده را بهصورت بومی در مقیاس بزرگ decompress کند و خطوط تحلیلی را از ابتدا تا انتها سرعت بخشد. این موتور بهصورت بومی از decompress دادههای فشردهشده با فرمتهای LZ4، Deflate و Snappy پشتیبانی میکند.
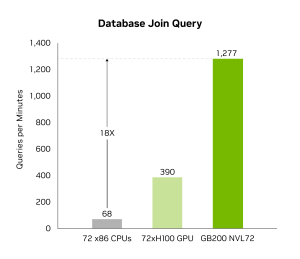
موتور decompression عملیات هستهای محدودشده به حافظه را تسریع میکند. این موتور عملکردی تا ۸۰۰ گیگابایت بر ثانیه ارائه میدهد و به Grace Blackwell امکان میدهد تا در معیارهای پرسوجو، ۱۸ برابر سریعتر از CPUها (Sapphire Rapids) و ۶ برابر سریعتر از پردازندههای گرافیکی Tensor Core H100 انویدیا عمل کند.
با پهنای باند حافظه فوقالعاده ۸ ترابایت بر ثانیه و اتصال پرسرعت NVlink-Chip-to-Chip (C2C) پردازنده Grace، این موتور کل فرآیند پرسوجوهای پایگاه داده را تسریع میبخشد. این امر منجر به عملکرد برتر در موارد استفاده تحلیل دادهها و علم داده میشود و به سازمانها امکان میدهد تا بینشهای خود را سریعتر به دست آورند و در عین حال هزینههای خود را کاهش دهند.
شبیهسازیهای مبتنی بر فیزیک
شبیهسازیهای مبتنی بر فیزیک همچنان پایه اصلی طراحی و توسعه محصولات محسوب میشوند. از هواپیماها و قطارها گرفته تا پلها، تراشههای سیلیکونی و حتی داروها، تست و بهبود محصولات از طریق شبیهسازی میلیاردها دلار صرفهجویی به همراه دارد.
مدارهای مجتمع با کاربرد خاص (ASIC) عمدتاً بر روی پردازندههای مرکزی (CPU) و در یک فرآیند طولانی و پیچیده طراحی میشوند که شامل تحلیل آنالوگ برای شناسایی ولتاژها و جریانها میشود. شبیهساز Cadence SpectreX نمونهای از این نوع حلکنندههاست. پیشبینی میشود که شبیهسازیهای مدار SpectreX روی ابرچیپ GB200 Grace Blackwell – که پردازندههای گرافیکی Blackwell و پردازندههای Grace را به هم متصل میکند – ۱۳ برابر سریعتر از پردازندههای مرکزی سنتی اجرا شوند.
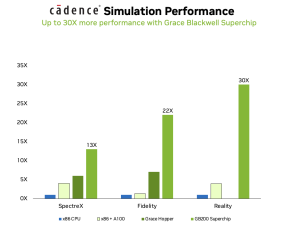
Cadence SpectreX (شبیهساز Spice) | پردازنده: ۱۶ هسته ای x86 CPU مجموعه داده: KeithC Design TSMC N5 | Cadence Fidelity (حلکننده CFD LES) | پردازنده: ۱۶ هسته ای x86 CPU مجموعه داده: GearPump 2M سلولی | پیشبینی عملکرد برای GB200 ممکن است در نمودار فوق تغییر کند
در طول دو سال گذشته، صنعت به طور فزایندهای به دینامیک سیالات محاسباتی (CFD) شتابیافته با GPU به عنوان یک ابزار کلیدی روی آورده است. مهندسان و طراحان تجهیزات از آن برای مطالعه و پیشبینی رفتار طراحیهای خود استفاده میکنند. پیشبینی میشود که شبیهسازیهای CFD با Cadence Fidelity روی سیستمهای GB200 تا ۲۲ برابر سریعتر از سیستمهای سنتی مبتنی بر CPU اجرا شوند.
ما مشتاقیم امکانهای Cadence Fidelity روی GB200 NVL72 را بررسی کنیم. با مقیاسپذیری موازی و ۳۰ ترابایت حافظه در هر رک، هدف ما ثبت جزئیات جریانی است که تاکنون ثبت نشدهاند.
جمع بندی
در این مقاله طراحی رک-اسکیل GB200 NVL72 را بررسی کردیم و به ویژه با قابلیت منحصر به فرد آن در اتصال ۷۲ پردازنده گرافیکی Blackwell در یک دامنه NVLink واحد آشنا شدیم. این فناوری سربار ارتباطی موجود هنگام مقیاسگذاری در شبکههای سنتی را به شدت کاهش میدهد. در نتیجه:
- امکان استنتاج بلادرنگ برای مدل زبانی بزرگ MoE با ۱.۸ تریلیون پارامتر فراهم شده است
- سرعت آموزش این مدل تا ۴ برابر افزایش یافته است
عملکرد ۷۲ پردازنده گرافیکی Blackwell متصل با NVLink، همراه با:
- ۳۰ ترابایت حافظه یکپارچه
- پهنای باند محاسباتی ۱۳۰ ترابایت بر ثانیه
یک ابررایانه هوش مصنوعی اگزافلاپ در تنها یک رک ایجاد میکند. این همان NVIDIA GB200 NVL72 است.